让 AI 学习过程可视化
一只猫拥有身体、关节和驱动器。现在它需要找到一种向前移动的方法。
最初的尝试可能显得笨拙:四肢相互干扰,失去平衡,付出巨大努力却几乎无法移动。经过多代试验后,某些动作开始产生有效的位移。部分控制策略被保留下来,新的移动方式也可能随之出现。
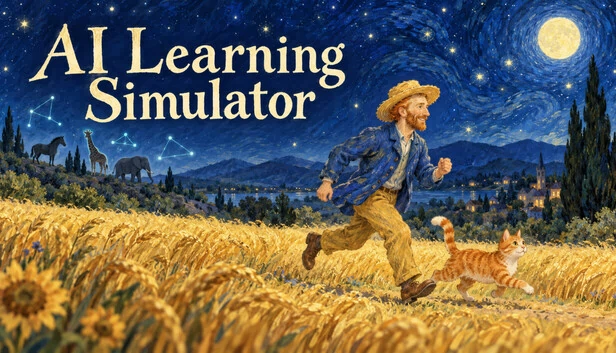
《AI Learning Simulator》是一款免费的基于物理的训练与观察游戏。设计身体、调整参数、运行训练,并观察神经网络如何在身体及其环境的约束下搜索有效行为。
每一项改进都可以成为人工智能领域的一项具体实验。
设计一个身体,然后观察它如何学习
从猫、大象、长颈鹿、马或双足动物开始。调整体型大小、肢体比例和重量,或在更精细的层级上编辑骨骼片段、关节和执行器安装点。
这些参数会直接改变学习问题。
更长的腿会改变活动范围以及平衡条件。更重的身体会增加负载。移动执行器的安装点会改变其围绕关节的力臂。相同的控制器在不同的身体上会产生截然不同的结果。
运动是由身体结构、执行器能力和控制策略的综合效应产生的。
骨架定义了身体如何运动,执行器提供动力,神经网络则整理来自输入端的控制信号。贴图赋予角色外观;而动作必须在物理模拟中得到验证。
神经网络如何将状态转化为动作
在当前游戏的控制模型中,网络接收每个线性执行器的相对伸展量。这些值是它观察身体的方式。
数值通过不同权重的连接进行传递。神经元还具有偏置和激活函数。对于单个神经元而言,其计算过程可以理解为:
输出 = 激活函数(Σ(输入 × 连接权重) + 偏置)
权重决定每个输入的影响程度。偏置改变神经元的响应。激活函数使网络能够形成更复杂的非线性关系。
节点与连接协同工作,为执行器生成控制输出。更改网络参数会改变身体对相同状态的响应方式。
每一次抬腿、支撑瞬间或失去平衡,都对应着一系列数值计算与物理反馈。
移动通过持续的反馈成型
控制不会在单次计算后结束。
执行器状态进入网络。它产生控制信号。执行器移动关节。重力和地面接触影响身体。由此产生的状态成为下一次计算的输入。
此循环持续进行:
身体状态 → 神经网络 → 执行器控制 → 物理运动 → 新的身体状态
输出的效果还取决于身体当前的姿势、运动状态和接触条件。同样的驱动在腿部在空中摆动时与触地时可能会产生不同的结果。
步态节奏与协调性可能会通过控制器、身体与环境之间的反馈逐渐显现。观察运动也意味着观察这一闭环系统的运作。
训练如何改变行为
该游戏主要通过神经进化来搜索控制策略。
训练过程会评估一组候选网络。在不同的控制参数下,每个网络会在其独立的物理模拟中尝试移动。每一代结束后,系统会比较性能表现,让更优的策略影响下一代,并通过变异引入新的尝试。
该过程会重复执行:
- 1. 生成候选控制网络的群体。
- 2. 运行固定时长的物理试验。
- 3. 移动分数表现。
- 4. 保留一些更好的策略并生成修改后的网络。
- 5. 再次测试并继续比较。
更改可以影响连接权重和神经元偏置,或添加节点与连接。网络结构本身也可以是搜索的一部分。
一个重要的区别在于:在试验期间,控制器会使用其当前参数反复进行计算。而在代际之间,训练过程会通过选择和变异来寻找新的参数。
移动的角色显示当前正在执行的策略。代际之间的差异显示了训练的结果。
它学习的内容取决于我们如何评估它
当前核心任务是在固定时间内尽可能向前移动。表现主要依据角色到达的最远水平位置进行评估。
这一简单的目标可以产生许多有趣的观察结果。
更进一步并不一定意味着动作更自然。在短距离试跑中表现出色,并不能保证长距离试跑的稳定性。力量与能量限制了动作表现,但距离、动作的优雅程度以及能量效率仍然是不同的目标。
训练会推动我们定义的指标向改进方向发展。该指标是否完全符合我们的预期,取决于实验设计者。
当出现意外行为时,请回顾:我们提供了哪些输入,允许了哪些操作,以及使用了哪些规则来定义成功?
理解这些问题是理解人工智能的一部分。
学习可能会停滞,且受其条件限制
训练过程中的进展很少是均匀的。
有时,整批尝试可能都显得无效。有时,一个微小的改动就能带来明显的提升。而在其他时候,性能在多个世代中可能保持相似水平。
种群规模影响尝试次数,变异程度影响探索范围,而身体结构则决定了可能的运动方式。更多的世代提供了更多的搜索机会,但无法保证每个身体都能学会稳定行走。
更多的神经元并不自动意味着更好的策略。
请结合身体、执行器能力、评估时长和评分规则来解读每一项结果。生成次数记录了已进行的评估轮数;实际能力仍需通过表现来判断。
更改条件,重新训练,并比较不同实验的结果。
保存您的实验
这款游戏提供了从设计到分享的完整路径:
- 选择身体模板:从猫、大象、长颈鹿、马或双足生物开始。
- 调整身体与执行器结构:修改尺寸、比例和重量;编辑关节及执行器连接点。
- 配置训练:调整种群规模、评估时长和进化参数,并观察其效果。
- 检查性能:观察网络结构、执行器信号、运动评分和训练代数。
- 保存并继续训练:保留身体配置和最佳策略,通过动物缩略图和累计代数识别结果,然后基于已保存的策略进一步探索。
- 在同一屏幕上观察与对比:独立回放两个角色习得的策略,以比较不同的身体或控制器。
- 更改外观并分享:使用动物、人类和绘本皮肤模板。通过 Steam 创意工坊下载或上传皮肤及训练结果。
游戏包含一个经过总计 280 代训练的猫策略。您可以直接回放它,或将其作为进一步训练的起点,并观察发生的变化。
一只猫的尝试揭示了人工智能学习的一小部分
在月光、星空与麦田交织的绘本场景中,细细品味策略操控的乐趣,或重塑躯体开启属于你的实验。
看似简单的向前移动,实则连接了输入编码、神经计算、身体动力学、评估规则与概率搜索。
我们希望这款免费游戏能将抽象概念转化为你可以反复观察、调整并测试的过程。建立你自己的判断:系统接收什么信息,它能执行哪些操作,以及在什么条件下会出现有效的行为?
由 Magiccat 开发,可免费使用。修改器在您的计算机本地运行。Steam 创意工坊功能需要登录 Steam 账号。
评论